Tampilkan postingan dengan label Data Mining. Tampilkan semua postingan

Selasa, 27 Maret 2012

Pengertian Decision tree

                       
                      Secara konsep Decision tree adalah salah satu dari teknik decision analysis.Tries sendiri pertama kali diperkenalkan pada tahun 1960-an oleh Fredkin. Trie atau digital tree berasal dari kata retrival (pengambilan kembali) sesuai dengan fungsinya. Secara etimologi kata ini diucapkan sebagai ‘tree’. Meskipun mirip dengan penggunaan kata ‘try’ tetapi hal ini bertujuan untuk membedakannya dari general tree. Dalam ilmu komputer, trie, atau prefix tree adalah sebuah struktur data dengan representasi ordered tree yang digunakan untuk menyimpan associative array yang berupa string. Berbeda dengan binary search tree (BST) yang tidak ada node di tree yang menyimpan elemen yang berhubungan dengan node sebelumnya dan, posisi setiap elemen di tree sangat menentukan. Semua keturunan dari suatu node mempunyai prefix string yang mengandung elemen dari node itu, dengan root merupakan string kosong. Values biasanya tidak terkandung di setiap node, hanya di daun dan beberapa node di tengah yang cocok dengan elemen tertentu.
                        Secara singkat bahwa Decision Tree merupakan salah satu metode klasifikasi pada Text Mining. Klasifikasi adalah proses menemukan kumpulan pola atau fungsi-fungsi yang mendeskripsikan dan memisahkan kelas data satu dengan lainnya, untuk dapat digunakan untuk memprediksi data yang belum memiliki kelas data tertentu (Jianwei Han, 2001).
                         Decision Tree adalah sebuah struktur pohon, dimana setiap node pohon merepresentasikan atribut yang telah diuji, setiap cabang merupakan suatu pembagian hasil uji, dan node daun (leaf) merepresentasikan kelompok kelas tertentu. Level node teratas dari sebuah Decision Tree adalah node akar (root) yang biasanya berupa atribut yang paling memiliki pengaruh terbesar pada suatu kelas tertentu. Pada umumnya Decision Tree melakukan strategi pencarian secara top-down untuk solusinya. Pada proses mengklasifikasi data yang tidak diketahui, nilai atribut akan diuji dengan cara melacak jalur dari node akar (root) sampai node akhir (daun) dan kemudian akan diprediksi kelas yang dimiliki oleh suatu data baru tertentu.
                        Decision Tree menggunakan algoritma ID3 atau C4.5, yang diperkenalkan dan dikembangkan pertama kali oleh Quinlan yang merupakan singkatan dari Iterative Dichotomiser 3 atau Induction of Decision “3″ (baca: Tree).
Algoritma ID3 membentuk pohon keputusan dengan metode divide-and-conquer data secara rekursif dari atas ke bawah. Strategi pembentukan Decision Tree dengan algoritma ID3 adalah:
• Pohon dimulai sebagai node tunggal (akar/root) yang merepresentasikan semua data..
• Sesudah node root dibentuk, maka data pada node akar akan diukur dengan information gain untuk dipilih atribut mana yang akan dijadikan atribut pembaginya.
• Sebuah cabang dibentuk dari atribut yang dipilih menjadi pembagi dan data akan didistribusikan ke dalam cabang masing-masing.
• Algoritma ini akan terus menggunakan proses yang sama atau bersifat rekursif untuk dapat membentuk sebuah Decision Tree. Ketika sebuah atribut telah dipilih menjadi node pembagi atau cabang, maka atribut tersebut tidak diikutkan lagi dalam penghitungan nilai information gain.
• Proses pembagian rekursif akan berhenti jika salah satu dari kondisi dibawah ini terpenuhi:
1. Semua data dari anak cabang telah termasuk dalam kelas yang sama.
2. Semua atribut telah dipakai, tetapi masih tersisa data dalam kelas yang berbeda. Dalam kasus ini, diambil data yang mewakili kelas yang terbanyak untuk menjadi label kelas pada node daun.
3. Tidak terdapat data pada anak cabang yang baru. Dalam kasus ini, node daun akan dipilih pada cabang sebelumnya dan diambil data yang mewakili kelas terbanyak untuk dijadikan label kelas.
Beberapa contoh pemakaian Decision Tree,yaitu :
• Diagnosa penyakit tertentu, seperti hipertensi, kanker, stroke dan lain-lain
• Pemilihan produk seperti rumah, kendaraan, komputerdanlain-lain
• Pemilihan pegawai teladan sesuai dengan kriteria tertentu
• Deteksi gangguan pada computer atau jaringan computer seperti Deteksi Entrusi, deteksi virus (Trojan dan varians),dan lain-lain
Pada project ini,Kami mencoba mengakali konsep decision tree dengan cara,mengubah implementasinya pada penjumlahan nilai dari tiap kepribadian.
Jadi gini,gampangannya..
Kunci dari program kami terletak pada pertanyaan utama.Jadi gini,4 kepribadian itu dibagi menjadi 2 golongan besar, yaitu :                       Ekstrovert : sanguinis dan Koleris
Introvert : Melankolis dan Plegmatis
Nilai Ekstrovert : sanguinis + Koleris
Nilia Introvert : Melankolis + Plegmatis

pertanyaan pertama pada aplikasi kami adalah mengkondisikan apakah jumlah nilai ekstrovert >= introvert.
apabila benar maka,tinggal membandingkan nilai sanguinis dan koleris,en klo jawabannya salah,maka program akan membandingkan nilai melankolis dan plegmatis.
Hasilnya adalah nilai kepribadian yang paling besar.
oia,setiap Nilai yang didapat akan disimpan kedalam temp,dan akan dimunculkan dalam bentuk grafik di program.

Materi Sistem Digital Karakter Kerja dari Gerbang

BAB I
PENDAHULUAN

        “Pada jaman sekarang ini, teknologi berkembang sangat pesat. Bermacam – macam alat dihasilkan Sekarang, hampir semua peralatan yang bekerja dengan tegangan listrik sudah menggunakan rangkaian digital. Saat ini rangkaian elektronika digital sudah bukan barang asing lagi. Rangkaian digital sudah ada di mana-mana dan bersinergi dengan rangkaian elektronika analog untuk membentuk rangkaian-rangkaian elektronika yang lebih cermat, cepat, dan tepat sasaran Sebenarnya, sebuah rangkaian digital tidak harus selalu berupa rangkaian rumit dengan banyak komponen kecil seperti yang kita lihat di dalam komputer, handphone, ataupun kalkulator. Sebuah rangkaian dengan kerja sederhana yang menerapkan prinsip-prinsip digital, juga merupakan sebuah rangkaian digital. Contoh rangkaian digital sederhana adalah rangkaian pengaman yang ditambahkan pada rangkaian kunci kontak sepeda motor atau mobil. Pada rangkaian pengaman terdapat kontak (berupa relay atau transistor) yang aktivitasnya dikontrol oleh pemilik sepeda motor. Kontak pengaman ini harus dihubungkan seri dengan rangkaian kunci kontak. Akibatnya, walau kunci kontak terhubung, sepeda motor tidak dapat distarter jika kontak pengaman ini masih terbuka. Cara ini cukup manjur untuk menghindari pencurian sepeda motor.
                 Gerbang (gate) dalam rangkaian logika merupakan fungsi yang menggambarkan hubungan antara masukan dan keluaran. Untuk menyatakan gerbang-gerbang tersebut biasanya digunakan simbol-simbol tertentu. Ada beberapa standar penggambaran simbol. Salah satu standar simbol yang populer adalah MIL-STD-806B yang dikeluarkan oleh Departemen Pertahanan Amerika Serikat untuk keperluan umum pada bulan Februari 1962. Untuk menunjukkan prinsip kerja tiap gerbang (atau rangkaian logika yang lebih kompleks) dapat digunakan beberapa cara. Cara yang umum dipakai antara lain adalah tabel kebenaran (truth table) dan diagram waktu (timing diagram). Karena merupakan rangkaian digital, tentu saja level kondisi 2 yang ada dalam tabel atau diagram waktu hanya dua macam, yaitu logika 0 (low, atau hight) dan logika 1 (atau False, atau true). Kondisi lain yang mungkin ada adalah kondisi X (level bebas, bisa logika 1 atau 0), dan kondisi high impedance (impedansi tinggi). Kondisi X biasanya ada di masukan gerbang dan menyatakan bahwa apa pun logika masukannya (logika 0 atau 1) tidak akan mempengaruhi logika keluaran yang dihasilkan. (Hodges D. , Jacson, Nasution S).”
             “Kondisi impedansi tinggi pada suatu titik (point) menunjukkan titik yang bersangkutan diisolasi dari rangkaian lain, sehingga tidak ada logika yang akan mempengaruhi titik tersebut gerbang dan rangkaian logika juga dapat diimplementasikan dalam bentuk rangkaian dioda, transistor, ataupun rangkaian terpadu yang disebut integrated circuit (IC). Dengan semakin majunya teknologi pembuatan komponen mikro-elektronika, perkembangan komponen IC untuk rangkaian digital menjadi pesat. IC logika jenis TTL (Transistor- Transistor Logic) dan CMOS (Complementary Metal Oxide Semiconductor) cukup populer di kalangan masyarakat penggemar elektronika. Walaupun sudah mulai berkurang, jenis IC tersebut masih banyak digunakan hingga saat ini.
Dalam mengimplementasikan rangkaian digital, kita juga dapat mengunakan Electronics Workbench (EWB) diteliti untuk diaplikasikan sebagai program simulasi bagi alat-alat elektronik yang dirancang. Dalam hal ini diteliti mengenai seberapa akurat respons yang diperoleh dari simulasi EWB dibandingkan dengan respons dari beberapa alat elektronik real dan juga seberapa banyak jenis alat elektronik yang dapat disimulasikan atau seberapa banyak jenis komponen atau rangkaian terintegrasi yang terdapat dalam EWB. Aplikasi EWB ini diharapkan dapat menjembatani kesenjangan antara teori dan praktek seperti disebut di atas. Biasanya pada suatu karya tulis ilmiah mengenai perancangan dan penganalisaan suatu alat elektronik hanyalah didasarkan pada studi literatur dan tidak melalui suatu pembuktian praktis. Pembuktian dengan komponen-komponen dan rangkaian-rangkaian terintegrasi fisik selain membutuhkan biaya pengadaan yang tinggi (untuk jenis dan jumlah besar), juga sering terjadi kerusakan pada komponen-komponen fisik tersebut. Penggunaan EWB dapat mengatasi kelemahan-kelemahan perangkat keras di atas dan membangkitkan kepercayaan diri para mahasiswa bahwa alat elektronik yang dirancang dapat bekerja seperti yang dikehendaki.

         Penelitian ini dibatasi dengan menguji coba alat elektronik analog, yang dirancang dan dianalisa oleh mahasiswa Jurusan Teknik Elektro untuk mata ajaran Analisa dan Perancangan. Penelitian ini bertujuan untuk menyelidiki keakuratan respons yang diperoleh dari simulasi EWB dibandingkan dengan respons secara fisik dan teoritis dari alat elektronik yang dipilih, yakni suatu alat elektronik analog dan berapa banyak jenis komponen atau rangkaian terintegrasi yang terdapat dalam EWB Transmitter vibrasi adalah alat yang dapat mengukur level dan komponen frekuensi dari vibrasi mesin secara elektronik serta dapat mengirimkan data-data itu ke ruang pemantauan sejauh 100 m dari alat tersebut. Transmitter vibrasi ini menggunakan suatu transduser vibrasi yang disebut akselerometer piezoelektrik / AP (piezoelectric accelerometer) dan terdiri dari penguat depan muatan, penguat instrumentasi, penguat tegangan tak membalik dua tingkat, filter lolos bawah, filter lolos pita, dan pengubah tegangan ke arus. Dengan software tersebut, kita dapat merancang dan menyimulasi rangkaian di komputer PC, Perancangan rangkaian dapat kita lakukan dengan cara skematis, yang menggunakan simbol-simbol layaknya menggambar rangkaian digital di kertas. Atau dengan bahasa VHDL (Visual Hardware Description Language) dan Verilog yang lebih sulit.”. (Boylestad, Robert dan Louis Nashelsky)

1.1. Latar Belakang
            “Gerbang yang diterjemahkan dari istilah asing gate, adalah elemen dasar dari semua rangkaian yang menggunakan sistem digital. Boleh jadi mereka mengena l istilah pencacah (counter), multiplekser ataupun encoder dan decoder dalam teknik digital, tetapi adakalanya mereka tidak tahu dari apa dan bagaimana alat-alat tersebut dibentuk. Ini dikarenakan oleh mudahnya mendapatkan fungsi tersebut dalam bentuk satu serpih IC (Integrated Circuit). Bagi yang telah mengetahui dari apa dan bagaimana suatu fungsi digital seperti halnya pencacah dibentuk hal ini tak akan menjadi masalah, namun bagi pemula dan autodidak yang terbiasa menggunakan serpih IC berdasarkan penggunaannya akan menjadi memiliki pendapat yang salah mengenai teknik digital. Untuk itulah artikel berikut yang ditujukan bagi pemula ditulis. Semua fungsi digital pada dasarnya tersusun atas gabungan beberapa gerbang logika dasar yang disusun berdasarkan fungsi yang diinginkan. Gerbang-gerbang dasar ini bekerja atas dasar logika tegangan yang digunakan dalam teknik digital. Logika tegangan adalah asas dasar bagi gerbang-gerbang logika”. (Hodges D. , Jacson, Nasution S).”

1.A . Sifat-Sifat Aljabar Boolean
                  Aljabar Boolean memuat variable dan simbul operasi untuk gerbang logika. Simbol yang digunakan pada aljabar Boolean adalah: (.) untuk AND, (+) untuk OR, dan ( ) untuk NOT. Rangkaian logika merupakan gabungan beberapa gerbang, untuk mempermudah penyeleseian perhitungan secara aljabar dan pengisian tabel kebenaran digunakan sifat-sifat aljabar Boolean:


a. Teori IDENTITAS

A.1 = A A+1 = 1
A.0 = 0 A+0 = A
A.A = A A+A = A
clip image00114 thumb Sifat Sifat Aljabar Booleanclip image00115 thumb Sifat Sifat Aljabar Boolean
A.A = A A+A = 1

b. Teori KOMUTATIF

A.B.C = C.B.A
     A+B+C = C+B+A

c. Teori ASOSIATIF

A.(B.C) = (A.B).C = A.B.C
                       A + ( B + C ) = ( A + B ) + C = A + B + C

d. Teori DISTRIBUTIF

A.B + A.C = A (B+C)

e. Teori DE MORGAN

A . B = A + B
A + B = A . B

1.2. Perumusan Masalah
             Permasalahan yang dibahas dalam makalah ini adalah mempelajari dan memahami tentang gerbang logika AND, NOT, OR dan NAND dengan menggunakan program Electronics Workbench (EWB) kemudian merealisasikannya dengan membangun sendiri sebuah premasalahan mengunakan gerbang NOT OR dan matrik AND. Dimana sebagai implementasi gerbang NAND dan di lanjutkan dengan menggunakan IC dan penerapan Dekoder.


1.3. Deskripsi Tentang Materi Praktek
1.3.1. Gerbang Logika
          “Gerbang logika atau gerbang logik adalah suatu entitas dalam elektronika dan matematika boolean yang mengubah satu atau beberapa masukan logik menjadi sebuah sinyal keluaran logik. Gerbang logika terutama diimplementasikan secara elektronis menggunakan dioda atau transistor, akan tetapi dapat pula dibangun menggunakan susunan komponen-komponen yang memanfaatkan sifat-sifat elektromagnetik (relay). Logika merupakan dasar dari semua penalaran (reasoning). Untuk menyatukan beberapa logika, kita membutuhkan operator logika dan untuk membuktikan kebenaran dari logika, kita dapat menggunakan tabel kebenaran. Tabel kebenaran menampilkan hubungan antara nilai kebenaran dari proposisi atomik. Dengan tabel kebenaran, suatu persamaan logika ataupun proposisi bisa dicari nilai kebenarannya. Tabel kebenaran pasti mempunyai banyak aplikasi yang dapat diterapkan karena mempunyai fungsi tersebut. Salah satu dari aplikasi tersebut yaitu dengan menggunakan tabel kebenaran kita dapat mendesain suatu rangkaian logika. Dalam makalah ini akan dijelaskan bagaimana peran dan kegunaan tabel kebenaran dalam proses pendesainan suatu rangkaian logika.

              Gerbang yang diterjemahkan dari istilah asing gate, adalah elemen dasar dari semua rangkaian yang menggunakan sistem digital. Semua fungsi digital pada dasarnya tersusun atas gabungan beberapa gerbang logika dasar yang disusun berdasarkan fungsi yang diinginkan. Gerbang -gerbang dasar ini bekerja atas dasar logika tegangan yang digunakan dalam teknik digital.Logika tegangan adalah asas dasar bagi gerbang-gerbang logika. Dalam teknik digital apa yang dinamakan logika tegangan adalah dua kondisi tegangan yang saling berlawanan. Kondisi tegangan “ada tegangan” mempunyai istilah lain “berlogika satu” (1) atau “berlogika tinggi” (high), sedangkan “tidak ada tegangan” memiliki istilah lain “berlogika nol” (0) atau “berlogika rendah” (low). Dalam membuat rangkaian logika kita menggunakan gerbang-gerbang logika yang sesuai dengan yang dibutuhkan. Rangkaian digital adalah sistem yang mempresentasikan sinyal sebagai nilai diskrit. Dalam sebuah sirkuit digital,sinyal direpresentasikan dengan satu dari dua macam kondisi yaitu 1 (high, active, true,) dan 0 (low, nonactive,false).” (Sendra, Smith, Keneth C)


1.3.2. Rangkaian Terpadu (IC) Untuk Gerbang -Gerbang Dasar

            “Setelah mengenal gerbang-gerbang dasar yang digunakan dalam teknik digital, bagi para pemula mengkin saja timbul pertanyaan dimana gerbang-gerbang ini dapat diperoleh? Jawabannya mudah sekali, karena gerbang- gerbang ini telah dijual secara luas dipasaran dalam IC tunggal (single chip). Yang perlu diperhatikan sekarang adalah dari jenis apa dan bagaimana penggunaan dari kaki-kaki IC yang telah didapat. Sebenarnya informasi dari IC-IC yang ada dapat dengan mudah ditemukan dalam buku data sheet IC yang sekarang ini banyak dijual. Namun sedikit contoh berikut mungkin akan me mpermudah pencarian. Berikut adalah keterangan mengenai IC-IC yang mengandung gerbang-gerbang logika dasar yang dengan mudah dapat dijumpai dipasaran.
Catatan:
  • Ada dua golongan besar IC yang umum digunakan yaitu TTL dan CMOS.
  • IC dari jenis TTL memiliki mutu yang relatif lebih baik daripada CMOS dalam hal daya yang dibutuhkan dan kekebalannya akan desah.
  • IC TTL membutuhkan catu tegangan sebesar 5 V sedangkan CMOS dapat diberi catu tegangan mulai 8 V sampai 15 V. Hali ini harus diingat benar-benar karena kesalahan pemberian catu akan merusakkan IC.
  • Karena adanya perbedaan tegangan catu maka tingkat tegangan logika juga akan berbeda. Untuk TTL logika satu diwakili oleh tegangan sebesar maksimal 5 V sedangkan untuk CMOS diwakili oleh tegangan yang maksimalnya sebesar catu yang diberikan, bila catu yang diberikan adalah 15 V maka logika satu akan diwakili oleh tegangan maksimal sebesar 15 V. Logika pada TTL dan CMOS adalah suatu tegangan yang harganya mendekati nol.
  • Untuk TTL nama IC yang biasanya terdiri atas susunan angka dimulai dengan angka 74 atau 54 sedangkan untuk CMOS angka ini diawali dengan 40.”(Ian Robertson Sinclair, Suryawan)
BAB II
TEORI

2.1. RANGKAIAN DASAR GERBANG LOGIKA

2.1.1. Gerbang Not (Not Gate)
           “Gerbang NOT atau juga bisa disebut dengan pembalik (inverter) memiliki fungsi membalik logika tegangan inputnya pada outputnya. Sebuah inverter (pembalik) adalah gerbang dengan satu sinyal masukan dan satu sinyal keluaran dimana keadaan keluaranya selalu berlawanan dengan keadaan masukan. Membalik dalam hal ini adalah mengubah menjadi lawannya. Karena dalam logika tegangan hanya ada dua kondisi yaitu tinggi dan rendah atau “1” dan “0”, maka membalik logika tegangan berarti mengubah “1” menjadi "0” atau sebaliknya mengubah nol menjadi satu. Simbul atau tanda gambar pintu NOT ditunjukkan pada gambar dibawah ini.

2.1.2. GERBANG AND (AND GATE)
     
           Gerbang AND (AND GATE) atau dapat pula disebut gate AND ,adalah suatu rangkaian logika yang mempunyai beberapa jalan masuk (input) dan hanya mempunyai satu jalan keluar (output). Gerbang AND mempunyai dua atau lebih dari dua sinyal masukan tetapi hanya satu sinyal keluaran. Dalam gerbang AND, untuk menghasilkan sinyal keluaran tinggi maka semua sinyal masukan harus bernilai tinggi.


2.1.3. GERBANG OR (OR GATE)

               Gerbang OR berbeda dengan gerbang NOT yang hanya memiliki satu input, gerbang ini memiliki paling sedikit 2 jalur input. Artinya inputnya bisa lebih dari dua, misalnya empat atau delapan. Yang jelas adalah semua gerbang logika selalu mempunyai hanya satu output. Gerbang OR akan memberikan sinyal keluaran tinggi jika salah satu atau semua sinyal masukan bernilai tinggi, sehingga dapat dikatakan bahwa gerbang OR hanya memiliki sinyal keluaran rendah jika semua sinyal masukan bernilai rendah.


2.1.4. Gerbang NAND

         Gerbang NAND adalah suatu NOT-AND, atau suatu fungsi AND yang dibalikkan. Dengan kata lain bahwa gerbang NAND akan menghasilkan sinyal keluaran rendah jika semua sinyal masukan bernilai tinggi.


2.1.5. Gerbang NOR

        Gerbang NOR adalah suatu NOT-OR, atau suatu fungsi OR yang dibalikkan sehingga dapat dikatakan bahwa gerbang NOR akan menghasilkan sinyal keluaran tinggi jika semua sinyal masukanya bernilai rendah.

2.1.6. Gerbang X-OR

          Gerbang X-OR akan menghasilkan sinyal keluaran rendah jika semua sinyal masukan bernilai rendah atau semua masukan bernilai tinggi atau dengan kata lain bahwa X-OR akan menghasilkan sinyal keluaran rendah jika sinyal masukan bernilai sama semua.

2.1.7. Gerbang X-NOR

          Gerbang X-NOR akan menghasilkan sinyal keluaran tinggi jika semua sinyal masukan bernilai sama (kebalikan dari gerbang X-OR).


CONTOH PENERAPAN GERBANG LOGIKA

Contoh1: F = A + B.C
Gambar1: Rangkain gerbang logika.

2.2. RANGKAIAN GERBANG KOMBINASI

            “Semua rangkaian logika dapat digolongkan atas dua jenis, yaitu rangkaian kombinasi (combinational circuit) dan rangkaian berurut (sequential circuit). Perbedaan kedua jenis rangkaian ini terletak pada sifat keluarannya. Keluaran suatu rangkaian kombinasi setiap saat hanya ditentukan oleh masukan yang diberikan saat itu. Keluaran rangkaian berurut pada setiap saat, selain ditentukan oleh masukannya saat itu, juga ditentukan oleh keadaan keluaran saat sebelumnya, jadi juga oleh masukan sebelumnya. Jadi, rangkaian berurut tetap mengingat keluaran sebelumnya dan dikatakan bahwa rangkaian ini mempunyai ingatan (memory). Kemampuan mengingat pada rangkaian berurut ini diperoleh dengan memberikan tundaan waktu pada lintasan balik (umpan balik) dari keluaran ke masukan. Secara diagram blok, kedua jenis rangkaian logika ini dapat digambarkan seperti pada Gambar 1.” (Albert Paul Malvino, Ph.D.)


Gambar 3. Model Umum Rangkaian Logika
(a) Rangkaian Kombinasi
(b) Rangkaian Berurut


2.2.1. PERANCANGAN RANGKAIAN KOMBINASI

                “Rangkaian kombinasi mempunyai komponen-komponen masukan, rangkaian logika, dan keluaran, tanpa umpan balik. Persoalan yang dihadapi dalam perancangan (design) suatu rangkaian kombinasi adalah memperoleh fungsi Boole beserta diagram rangkaiannya dalam bentuk susunan gerbang-gerbang. Seperti telah diterangkan sebelumnya, fungsi Boole merupakan hubungan aljabar antara masukan dan keluaran yang diinginkan. Langkah pertama dalam merancang setiap rangkaian logika adalah menentukan apa yang hendak direalisasikan oleh rangkaian itu yang biasanya dalam bentuk uraian kata-kata (verbal). Berdasarkan uraian kebutuhan ini ditetapkan jumlah masukan yang dibutuhkan serta jumlah keluaran yang akan dihasilkan. Masing-masing masukan dan keluaran diberi nama simbolis. Dengan membuat tabel kebenaran yang menyatakan hubungan masukan dan keluaran yang diinginkan, maka keluaran sebagai fungsi masukan dapat dirumuskan dan disederhanakan dengan cara-cara yang telah diuraikan dalam bab-bab sebelumnya.

                Berdasarkan persamaan yang diperoleh ini, yang merupakan fungsi Boole dari pada rangkaian yang dicari, dapat digambarkan diagram rangkaian logikanya Ada kalanya fungsi Boole yang sudah disederhanakan tersebut masih harus diubah untuk memenuhi kendala yang ada seperti jumlah gerbang dan jenisnya yang tersedia, jumlah masukan setiap gerbang, waktu perambatan melalui keseluruhan gerbang (tundaan waktu), interkoneksi antar bagian-bagian rangkaian, dan kemampuan setiap gerbang untuk mencatu (drive) gerbang berikutnya. Harga rangkaian logika umumnya dihitung menurut cacah gerbang dan cacah masukan keseluruhannya. Ini berkaitan dengan cacah gerbang yang dikemas dalam setiap kemasan.

           Gerbang-gerbang logika yang tersedia di pasaran pada umumnya dibuat dengan teknologi rangkaian terpadu (Integrated Circuit, IC). Pemaduan (integrasi) gerbang-gerbang dasar seperti NOT, AND, OR, NAND, NOR, XOR pada umumnya dibuat dalam skala kecil (Small Scale Integration, SSI) yang mengandung 2 sampai 6 gerbang dalam setiap kemasan. Kemasan yang paling banyak digunakan dalam rangkaian logika sederhana berbentuk DIP (Dual- In-line Package), yaitu kemasan dengan pen-pen hubungan ke luar disusun dalam dua baris sejajar. Kemasan gerbang-gerbang dasar umunya mempunyai 14-16 pen, termasuk pen untuk catu daya positif dan nol (Vcc dan Ground). Setiap gerbang dengan 2 masukan membutuhkan 3 pen (1 pen untuk keluaran) sedangkan gerbang 3 masukan dibutuhkan 4 pen. Karena itu, satu kemasan 14 pen dapat menampung hanya 4 gerbang 2 masukan atau 3 gerbang 3 masukan.

            Dalam praktek kita sering terpaksa menggunakan gerbang-gerbang yang tersedia di pasaran yang kadang-kadang berbeda dengan kebutuhan rancangan kita. Gerbang yang paling banyak tersedia di pasaran adalah gerbang-gerbang dengan 2 atau 3 masukan. Umpamanya, dalam rancangan kita membutuhkan gerbang dengan 4 atau 5 masukan dan kita akan mengalami kesulitan memperoleh gerbang seperti itu. Karena itu kita harus mengubah rancangan sedemikian sehingga rancangan itu dapat direalisasikan dengan gerbang-gerbang dengan 2 atau 3 masukan. Kemampuan pencatuan daya masing-masing gerbang juga membutuhkan perhatian. Setiap gerbang mampu mencatu hanya sejumlah tertentu gerbang lain di keluarannya (disebut sebagai fan-out). Ini berhubungan dengan kemampuan setiap gerbang dalam menyerap dan mencatu arus listrik. Dalam perancangan harus kita yakinkan bahwa tidak ada gerbang yang harus mencatu terlalu banyak gerbang lain di keluarannya. Ini sering membutuhkan modifikasi rangakaian realisasi yang berbeda dari rancangan semula. Mengenai karakteristik elektronik gerbang-gerbang logika dibahas dalam Lampiran A.” (Albert Paul Malvino, Ph.D.)

2.3. IMPLEMENTASI RANGKAIAN GERBANG LOGIKA DENGAN GERBANG NAND

2.3.1. Gerbang NAND (NOT And)

          “Gerbang NAND dan NOR merupakan gerbanguniversal, artinya hanya dengan menggunakan jenisgerbang NAND saja atau NOR sajadapat menggantikan fungsi dari 3 gerbang dasar yang lain (AND, OR, NOT). Multilevel, artinya: denganmengimplementasikan gerbang NAND atau NOR, akan ada banyak level / tingkatan mulai dari sisitem input sampai kesisi output. Keuntungan pemakaian NAND saja atau NOR saja dalam sebuah rangkaian digital adalah dapat mengoptimalkan pemakaian seluruh gerbang yang terdapat dalam sebuah IC, sehingga menghemat biaya
        Gerbang NAND adalah pengembangan dari gerbang AND. Gerbang ini sebenarnya adalah gerbang AND yang pada outputnya dipasang gerbang NOT. Gerbang yang paling sering digunakan untuk membentuk rangkaian kombinasi adalah gerbang NAND dan NOR, dibanding dengan AND dan OR. Dari sisi aplikasi perangkat luar, gerbang NAND dan NOR lebih umum sehingga gerbang-gerbang tersebut dikenal sebagai gerbang yang “universal”. Gerbang-gerbang NOT, AND dan OR dapat di-substitusi ke dalam bentuk NAND saja, dengan hubungan seperti gambar 2. 


Gambar 4. Substitusi Beberapa Gerbang Dasar Menjadi NAND


Rangkaian Asal Rangkaian Dengan NAND saja

Gambar 5, impelemtasi Gergang NAND

           Untuk mendapatkan persamaan dengan menggunakan NAND saja, maka persamaan asal harus dimodifikasi sedemikian rupa, sehingga hasil akhir yang didapatkan adalah persamaan dengan NAND saja. Gerbang NAND sangat banyak di pakai dalam computer modern dan mengeti pemakaiannya sangat berharga bagi kita, untuk merancang jaringan gerbang NAND ke NAND, gunakan prosedur tabel kombinasi untuk ungkapan jumlah hasil kali,
             Dalam perancangan logika, gerbang logika siskrit tidak selalu digunakan ttapi biasanya beisi banyak gerbang, karena itu, biasanya lebih disukai untuk memanfaatkan satu jenis gerbang, dan bukan campuran beberapa gerbang untuk alasan ini konversi gerbang digunakan untuk menyatukan suatu fungsi gerbang tertentu dengan cara mengombinasikan beberapa gerbang yang bertipe sama, suatu misal implementasi gerbang NAND ke dalam gerbang NO, gerbang AND dan gerbang OR (Kf Ibrahim, “Tehnik Digital”)
             Pertimbangan lain nya dalam impelemtasi fungis boole berkaitan dengan jenis gate yang digunakan, seringkali di rasakan perlu nya untuk mengimplimentasikan fungsi boole dengan hanya menggunakan gate-gate NAND saja, walaupun mungkin tidak merupakan implementasi gate minimum, teknik tersebut memiliki keuntungan dan keteraturan yang dapat menyederhanakan proses pembuatan nya di pabrik. (wiliam steling).


2.4. Decoder
             “Decoder adalah suatu rangkaian logika kombinasional yang mampu mengubah masukan kode biner n-bit ke m-saluran keluaran sedemikian rupa sehingga setiap saluran keluaran hanya satu yang akan aktif dari beberapa kemungkinan kombinasi masukan. Gambar 2.14 memperlihatkan diagram dari decoder dengan masukam n = 2 dan keluaran m = 4 ( decoder 2 ke 4). Setiap n masukan dapat berisi logika 1 atau 0, ada 2N kemungkinan kombinasi dari masukan atau kode-kode. Untuk setiap kombinasi masukan ini hanya satu dari m keluaran yang akan aktif (berlogika 1), sedangkan keluaran yang lain adalah berlogika 0. Beberapa decoder didisain untuk menghasilkan keluaran low pada keadan aktif, dimana hanya keluaran low yang dipilih akan aktif sementara keluaran yang lain adalah berlogika 1. Dari keadaaan aktif keluaranya, decoder dapat dibedakan atas “non inverted output” dan “inverted output”. (David Bucchlah, Wayne McLahan).

Gerbang Logika Dasar

                     Gerbang logika merupakan dasar pembentuk system digital. Gerbang logika beroperasi pada bilangan biner 1 dan 0. Gerbang logika digunakan dalam berbagai rangkaian elektronik dengan system digital. Berkaitan dengan tegangan yang digunakan maka tegangan tinggi berarti 1 dan tegangan rendah adalah 0.

Semua sistem digital disusun hanya menggunakan tiga gerbang yaitu: NOT, AND dan OR.

1. Fungsi AND gate

Fungsi AND dapat digambarkan dengan rangkaian listrik menggunakan saklar seperti dibawah ini:
clip image002 thumb1 Gerbang Logika Dasar

Keterangan:
A & B adalah saklar
Y adalah lampu
                       Jika saklar dibuka maka berlogika 0, jika saklar ditutup disebut berlogika 1. Fungsi logika yang dijalankan rangkaian AND adalah sebagai berikut:
1. Jika kedua saklar A & B dibuka maka lampu padam
2. Jika salah satu dalam keadaan tertutup maka lampu padam
3. Jika kedua saklar tertutup maka lampu nyala

Simbol Gerbang AND Tabel Kebenaran
INPUT OUTPUT
clip image004 thumb1 Gerbang Logika DasarA B Y
0 0 0
0 1 0
1 0 0
1 1 1
 
                         Karakteristik: Jika A da B adalah input, sedangkan Y adalah Output, maka output gerbangnya AND berlogika 1 jika semua inputnya berlogika 1. Dan output berlogika 0 jika kedua atau salah satu inputnya berlogika 0.

2. Fungsi OR gate
                       Funsi OR dapat digambarkan dengan rangkaian seperti dibawah ini.
clip image006 thumb Gerbang Logika Dasar

Keterangan:
A dan B =Saklar
Y= lampu
Jika saklar dibuka maka berlogika 0, jika saklar ditutup disebur berlogika 1.
Simbol Gerbang OR Tabel kebenaran 

INPUT OUTPUT
clip image008 thumb Gerbang Logika DasarA B Y
0 0 0
0 1 1
1 0 1
1 1 1

                      Karakteristik: Jika A dan B adalah input sedangkan Y output maka output gerbang OR akan berlogika 1 jika salah satu atau kedua input adalah berlogika 1.

3. Fungsi NOT gate
                        Fungsi NOT dapat digambarkan dengan rangkaian seperti gambar dibawah ini:
clip image010 thumb Gerbang Logika Dasar

                         Jika saklar dibuka maka berlogika 0, jika saklar ditutup disebut berlogika 1.
Simbol Fungsi NOT Tabel Kebenaran 

clip image012 thumb Gerbang Logika DasarINPUT OUTPUT
A Y
0 1
1 0
                       
                      Karakteristik: Jika adalah input, output adalah kebalikan dari input. Artinya Jika input berlogika 1 maka output akan berlogika 0 dan sebaliknya.

4. Fungsi NAND gate
                        NAND adalah rangkaian dari NOT AND. Gerbang NAND merupakan gabungan dari NOR dan AND digambarkan sebagai berikut:
clip image014 thumb Gerbang Logika Dasar


Menjadi:
clip image016 thumb Gerbang Logika Dasar

clip image018 thumb Gerbang Logika Dasar
NAND sebagai sakelar

Dari Gambar diatas dapat dibuat tabel kebenaran sebagai berikut: 

C Output
A B Y
0 0 1
0 1 1
1 0 1
1 1 0

                       Karakteristiknya: Jika A dan B input sedangkan Y adalah output maka output gerbang NAND akan berlogika 1 jika salah satu inputnya berlogika 0. Dan output akan berlogika 0 jika kedua inputnya berlogika 1. Atau output gerbang NAND adalah komplemen output gerbang AND.

5. Fungsi NOR gate
                       NOR adalah singkatan dari NOT OR. Gerbang NOR merupakan gabungan dari gerbang NOT dan OR. Digambarkan sebagai berikut:
clip image020 thumb Gerbang Logika Dasar

menjadi:
clip image022 thumb Gerbang Logika Dasar

clip image024 thumb Gerbang Logika Dasar
NOR dengan saklar

Dari rangkaian diatas dapat dibuat tabel kebenaran sebagai berikut: 

Input Output
A B Y
0 0 0
0 1 0
1 0 0
1 1 1

                        Karakteristik: jika A dan B adalah input dan Y adalah output maka output gerbang NOR berlogika 1 jika semua input berlogika 1 dan output akan berlogika 0 jika salah satu atau semua inputnya berlogika 0. Atau output gerbang NOR merupakan output gerbang OR

6. Fungsi EX-OR (Exlusive OR)
                         Gerbang X-OR akan memberikan output berlogika 1 jika jumlah logika jumlah logika 1 pada inputnya ganjil. Rangkaian EX-OR disusun dengan menggunkan gerbang AND, OR, NOT seperti dibawah ini.
Simbol Gerbang EX-OR
clip image027 thumb Gerbang Logika Dasar clip image029 thumb Gerbang Logika Dasar
Dari gambar diatas dapat dibuat tabel kebenaran sebagai berikut:
Input Output
A B Y
0 0 0
0 1 1
1 0 1
1 1 0

7. Fungsi EX-NOR
                      Gerbang X-NOR akan memberikan output berlogika 0 jika jumlah logika 1 pada inputnya ganjil. Dan akan berlogika 1 jika kedua inputnya sama. Rangkaian EX-NOR disusun dengan menggunka gerbang AND, OR, NOT seperti dibawah ini.
Simbol Gerbang EX-NOR
clip image031 thumb Gerbang Logika Dasar

Dari gambar diatas dapat dibuat tabel kebenaran sebagai berikut:

Input Output
A B Y
0 0 1
0 1 0
1 0 0
1 1


BAB III

Langkah-langkah kegiatan

3.1. langkah kegiatan I
3.1.1. Instalasi Electronic Workbench
     
                        Pada praktikum ini kita akan menggunakan sofewere Elektronik Workbench atau EWB adalah softwere yang digunakan dalam praktek system digital yang diberikan oleh dosen. Cara penggunan dan penginstalannya sangatlah mudah, sebelum kita beranjak lebih lanjut terlebih dahulu kita akan membahas bagaimana cara penginstalan sofewer tersebut, berikut proses pengistalan nya:
Langkah pertama adalah copy atau download master electronics workbench dan cari tempat folder nya seperti gambar di bawah ini
untuk lebih lengakp silahkan DOWNLOAD di sini

Materi Data Mining Pohon Keputusan

  • Latar Belakang Pohon Keputusan
  • Pengertian Pohon Keputusan
  • Manfaat Pohon Keputusan
  • Kelebihan Pohon Keputusan
  • Kekurangan Pohon Keputusan
  • Model Pohon Keputusan
  • Algoritman C.45
  • Contoh-contoh aplikasi


Latar Belakang Pohon Keputusan
                       Di dalam kehidupan manusia sehari-hari, manusia selalu dihadapkan oleh berbagai macam masalah dari berbagai macam bidang. Masalah-masalah ini yang dihadapi oleh manusia tingkat kesulitan dan kompleksitasnya sangat bervariasi, mulai dari yang teramat sederhana dengan sedikit faktor-faktor yang berkaitan dengan masalah tersebut dan perlu diperhitungkan sampai dengan yang sangat rumit dengan banyak sekali faktor-faktor turut serta berkaitan dengan masalah tersebut dan perlu untuk diperhitungkan. Untuk menghadapi masalah-masalah ini, manusia mulai mengembangkan sebuah sistem yang dapat membantu manusia agar dapat dengan mudah mampu untuk menyelesaikan masalah-masalah tersebut.
                       Adapun pohon keputusan ini adalah sebuah jawaban akan sebuah sistem yang manusia kembangkan untuk membantu mencari dan membuat keputusan untuk masalah-masalah tersebut dan dengan memperhitungkan berbagai macam factor yang ada di dalam lingkup masalah tersebut. Dengan pohon keputusan, manusia dapat dengan mudah melihat mengidentifikasi dan melihat hubungan antara faktor-faktor yang mempengaruhi suatu masalah dan dapat mencari penyelesaian terbaik dengan memperhitungkan faktor-faktor tersebut.
                      Pohon keputusan ini juga dapat menganalisa nilai resiko dan nilai suatu informasi yang terdapat dalam suatu alternatif pemecahan masalah. Peranan pohon keputusan ini sebagai alat Bantu dalam mengambil keputusan (decision support tool) telah dikembangkan oleh manusia sejak perkembangan teori pohon yang dilandaskan pada teori graf. Kegunaan pohon keputusan yang sangat banyak ini membuatnya telah dimanfaatkan oleh manusia dalam berbagai macam sistem pengambilan keputusan.

Pengertian Pohon Keputusan

Pohon yang dalam analisis pemecahan masalah pengambilan keputusan adalah pemetaan mengenai alternatif-alternatif pemecahan masalah yang dapat diambil dari masalah tersebut. Pohon tersebut juga memperlihatkan faktor-faktor kemungkinan/probablitas yang akan mempengaruhi alternatif-alternatif keputusan tersebut, disertai dengan estimasi hasil akhir yang akan didapat bila kita mengambil alternatif keputusan tersebut.

Manfaat Pohon Keputusan

                       Pohon keputusan adalah salah satu metode klasifikasi yang paling populer karena mudah untuk diinterpretasi oleh manusia. Pohon keputusan adalah model prediksi menggunakan struktur pohon atau struktur berhirarki. Konsep dari pohon keputusan adalah mengubah data menjadi pohon keputusan dan aturan-aturan keputusan. Manfaat utama dari penggunaan pohon keputusan adalah kemampuannya untuk mem-break down proses pengambilan keputusan yang kompleks menjadi lebih simpel sehingga pengambil keputusan akan lebih menginterpretasikan solusi dari permasalahan. Pohon Keputusan juga berguna untuk mengeksplorasi data, menemukan hubungan tersembunyi antara sejumlah calon variabel input dengan sebuah variabel target. Pohon keputusan memadukan antara eksplorasi data dan pemodelan, sehingga  sangat bagus sebagai langkah awal dalam proses pemodelan bahkan ketika dijadikan sebagai model akhir dari beberapa teknik lain.
                      Sering terjadi tawar menawar antara keakuratan model dengan transparansi model. Dalam beberapa aplikasi, akurasi dari sebuah klasifikasi atau prediksi adalah satu-satunya hal yang ditonjolkan, misalnya sebuah perusahaan direct mail membuat sebuah model yang akurat untuk
memprediksi anggota mana yang berpotensi untuk merespon permintaan, tanpa memperhatikan bagaimana atau mengapa model tersebut bekerja.

Kelebihan Pohon Keputusan

Kelebihan dari metode pohon keputusan adalah:
  • Daerah pengambilan keputusan yang sebelumnya kompleks dan sangat global, dapat diubah menjadi lebih simpel dan spesifik.
  • Eliminasi perhitungan-perhitungan yang tidak diperlukan, karena ketika menggunakan metode pohon keputusan maka sample diuji hanya berdasarkan kriteria atau kelas tertentu.
  • Fleksibel untuk memilih fitur dari internal node yang berbeda, fitur yang terpilih akan membedakan suatu kriteria dibandingkan kriteria yang lain dalam node yang sama. Kefleksibelan metode pohon keputusan ini meningkatkan kualitas keputusan yang dihasilkan jika dibandingkan ketika menggunakan metode penghitungan satu tahap yang lebih konvensional
  • Dalam analisis multivariat, dengan kriteria dan kelas yang jumlahnya sangat banyak, seorang penguji biasanya perlu untuk mengestimasikan baik itu distribusi dimensi tinggi ataupun parameter tertentu dari distribusi kelas tersebut. Metode pohon keputusan dapat menghindari munculnya permasalahan ini dengan menggunakan criteria yang jumlahnya lebih sedikit pada setiap node internal tanpa banyak mengurangi kualitas keputusan yang dihasilkan.

Kekurangan Pohon Keputusan

  • Terjadi overlap terutama ketika kelas-kelas dan criteria yang digunakan jumlahnya sangat banyak. Hal tersebut juga dapat menyebabkan meningkatnya waktu pengambilan keputusan dan jumlah memori yang diperlukan.
  • Pengakumulasian jumlah eror dari setiap tingkat dalam sebuah pohon keputusan yang besar.
  • Kesulitan dalam mendesain pohon keputusan yang optimal.
  • Hasil kualitas keputusan yang didapatkan dari metode pohon keputusan sangat tergantung pada bagaimana pohon tersebut didesain.

Model Pohon Keputusan

                         Pohon keputusan adalah model prediksi menggunakan struktur pohon atau struktur berhirarki. Contoh dari pohon keputusan dapat dilihat di Gambar berikut ini.
                       Disini setiap percabangan menyatakan kondisi yang harus dipenuhi dan tiap ujung pohon menyatakan kelas data. Contoh di Gambar 1 adalah identifikasi pembeli komputer,dari pohon keputusan tersebut diketahui bahwa salah satu kelompok yang potensial membeli komputer adalah orang yang berusia di bawah 30 tahun dan juga pelajar. Setelah sebuah pohon keputusan dibangun maka dapat digunakan untuk mengklasifikasikan record yang belum ada kelasnya. Dimulai dari node root, menggunakan tes terhadap atribut dari record yang belum ada kelasnya tersebut lalu mengikuti cabang yang sesuai dengan hasil dari tes tersebut, yang akan membawa kepada internal node (node yang memiliki satu cabang masuk dan dua atau lebih cabang yang keluar), dengan cara harus melakukan tes lagi terhadap atribut atau node daun. Record yang kelasnya tidak diketahui kemudian diberikan kelas yang sesuai dengan kelas yang ada pada node daun. Pada pohon keputusan setiap simpul daun menandai label kelas. Proses dalam pohon keputusan yaitu mengubah bentuk data (tabel) menjadi model pohon (tree) kemudian mengubah model pohon tersebut menjadi aturan (rule).

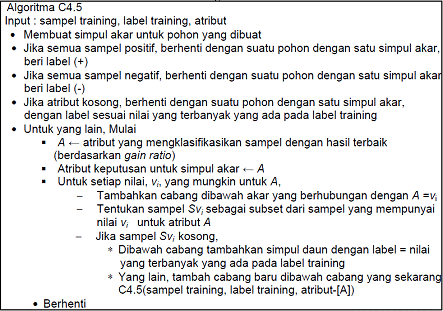
ALGORITMA C4.5

                       Salah satu algoritma induksi pohon keputusan yaitu ID3 (Iterative Dichotomiser 3). ID3 dikembangkan oleh J. Ross Quinlan. Dalam prosedur algoritma ID3, input berupa sampel training, label training dan atribut. Algoritma C4.5 merupakan pengembangan dari ID3. Sedangkan pada perangkat lunak open source WEKA mempunyai versi sendiri C4.5 yang dikenal sebagai J48.
Algoritma C4.5
Algoritma C4.5
                       Pohon dibangun dengan cara membagi data secara rekursif hingga tiap bagian terdiri dari data yang berasal dari kelas yang sama. Bentuk pemecahan (split) yang digunakan untuk membagi data tergantung dari jenis atribut yang digunakan dalam split. Algoritma C4.5 dapat menangani data numerik (kontinyu) dan diskret. Split untuk atribut numerik yaitu mengurutkan contoh berdasarkan atribut kontiyu A, kemudian membentuk minimum permulaan (threshold) M dari contoh-contoh yang ada dari kelas mayoritas pada setiap partisi yang bersebelahan, lalu menggabungkan partisi-partisi yang bersebelahan tersebut dengan kelas mayoritas yang sama.
 Split untuk atribut diskret A mempunyai bentuk value (A) ε X dimana X ⊂ domain(A).
                       Jika suatu set data mempunyai beberapa pengamatan dengan missing value yaitu record dengan beberapa nilai variabel tidak ada, Jika jumlah pengamatan terbatas maka atribut dengan missing value dapat diganti dengan nilai rata-rata dari variabel yang bersangkutan.[Santosa,2007]
Untuk melakukan pemisahan obyek (split) dilakukan tes terhadap atribut dengan mengukur tingkat ketidakmurnian pada sebuah simpul (node). Pada algoritma C.45 menggunakan rasio perolehan (gain ratio). Sebelum menghitung rasio perolehan, perlu menghitung dulu nilai informasi dalam satuan bits dari suatu kumpulan objek. Cara menghitungnya dilakukan dengan menggunakan konsep entropi.

Entropy 
 
                       S adalah ruang (data) sampel yang digunakan untuk pelatihan, p+ adalah jumlah yang bersolusi positif atau mendukung pada data sampel untuk kriteria tertentu dan p- adalah jumlah yang bersolusi negatif atau tidak mendukung pada data sampel untuk kriteria tertentu. ntropi(S) sama dengan 0, jika semua contoh pada S berada dalam kelas yang sama. Entropi(S) sama dengan 1, jika jumlah contoh positif dan negative dalam S adalah sama. Entropi(S) lebih dari 0 tetapi kurang dari 1, jika jumlah contoh positif dan negative dalam S tidak sama [Mitchell,1997].Entropi split yang membagi S dengan n record menjadi himpunan-himpunan S1 dengan n1 baris dan S2 dengan n2 baris adalah :


                         Kemudian menghitung perolehan informasi dari output data atau variabel dependent y yang dikelompokkan berdasarkan atribut A, dinotasikan dengan gain (y,A). Perolehan informasi, gain (y,A), dari atribut A relative terhadap output data y adalah:


                         nilai (A) adalah semua nilai yang mungkin dari atribut A, dan yc adalah subset dari y dimana A mempunyai nilai c. Term pertama dalam persamaan diatas adalah entropy total y dan term kedua adalah entropy sesudah dilakukan pemisahan data berdasarkan atribut A.
                        Untuk menghitung rasio perolehan perlu diketahui suatu term baru yang disebut pemisahan informasi (SplitInfo). Pemisahan informasi dihitung dengan cara :

split
 
                         bahwa S1 sampai Sc adalah c subset yang dihasilkan dari pemecahan S dengan menggunakan atribut A yang mempunyai sebanyak c nilai. Selanjutnya rasio perolehan (gain ratio) dihitung dengan cara :


Contoh Aplikasi

Credit Risk

                       Berikut ini merupakan contoh dari salah satu kasus resiko kredit (credit risk) yang menggunakan decision tree untuk menentukan apakah seorang potential customer dengan karakteristik saving, asset dan income tertentu memiliki good credit risk atau bad credit risk.


                       Dapat dilihat pada gambar tersebut, bahwa target variable dari decision tree tersebut atau variable yang akan diprediksi adalah credit risk dengan menggunakan predictor variable : saving, asset, dan income. Setiap nilai atribut dari predictor variable akan memiliki cabang menuju predictor variable selanjutnya, dan seterusnya hingga tidak dapat dipecah dan menuju pada target variable.
                       Penentuan apakah diteruskan menuju predictor variable (decision node) atau menuju target variable (leaf node) tergantung pada keyakinan (knowledge) apakah potential customer dengan nilai atribut variable keputusan tertentu memiliki keakuratan nilai target variable 100% atau tidak. Misalnya pada kasus di atas untuk saving medium, ternyata knowledge yang dimiliki bahwa untuk seluruh potential customer dengan saving medium memiliki credit risk yang baik dengan keakuratan 100%. Sedangkan untuk nilai low asset terdapat kemungkinan good credit risk dan bad credit risk.
                      Jika tidak terdapat pemisahan lagi yang mungkin dilakukan, maka algoritma decision tree akan berhenti membentuk decision node yang baru. Seharusnya setiap branches diakhiri dengan “pure” leaf node, yaitu leaf node dengan target variable yang bersifat unary untuk setiap records pada node tersebut, di mana untuk setiap nilai predictor variable yang sama akan memiliki nilai target variable yang sama. Tetapi, terdapat kemungkinan decision node memiliki “diverse” atributes, yaitu bersifat non‐unary untuk nilai target variablenya, di mana untuk setiap record dengan nilai predictor variable yang sama ternyata memiliki nilai target variable yang berbeda. Kondisi tersebut menyebabkan tidak dapat dilakukan pencabangan lagi berdasarkan nilai predictor variable. Sehingga solusinya adalah membentuk leaf node yang disebut “diverse” leaf node, dengan menyatakan level kepercayaan dari diverse leaf node tersebut. Misalnya untuk contoh data berikut ini :


                       Dari training data tersebut kemudian disusunlah alternatif untuk candidate split, sehingga setiap nilai untuk predictor variable di atas hanya membentuk 2 cabang, yaitu sebagai berikut:

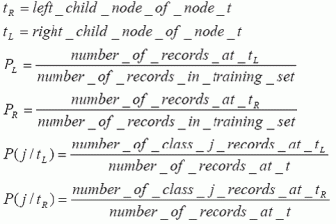
Kemudian untuk setiap candidate split di atas, dihitung variabel‐variabel berikut berdasarkan training data yang dimiliki. Adapun variabel‐variabel tersebut, yaitu :

,di mana

Adapun contoh hasil perhitungannya adalah sebagai berikut :

                        Dapat dilihat dari contoh perhitungan di atas, bahwa yang memiliki nilai goodness of split * Φ(s/t) + yang terbesar, yaitu split 4 dengan nilai 0.64275. Oleh karena itu split 4 lah yang akan digunakan pada root node, yaitu split dengan : assets = low dengan assets = {medium, high}.
                        Untuk penentuan pencabangan, dapat dilihat bahwa dengan assets=low maka didapatkan pure node leaf, yaitu bad risk (untuk record 2 dan 7). Sedangkan untuk assets = {medium, high} masih terdapat 2 nilai, yaitu good credit risk dan bad credit risk. Sehingga pencabangan untuk assets = {medium, high} memiliki decision node baru. Adapun pemilihan split yang akan digunakan, yaitu dengan menyusun perhitungan nilai Φ(s/t) yang baru tanpa melihat split 4, record 2 dan 7.


Demikian seterusnya hingga akhirnya dibentuk leaf node dan membentuk decision tree yang utuh (fully grown form) seperti di bawah ini :

Sistem Pakar Diagnosa Penyakit (Kusrini)

Dalam aplikasi ini terdapat tabel-tabel sebagai berikut:
  • Tabel Rekam_Medis, berisi data asli rekam medis pasien
  • Tabel Kasus, beisi data variabel yang dapat mempengaruhi kesimpulan diagnosis dari pasien-pasien yang ada, misalnya Jenis Kelamin, Umur, Daerah_Tinggal, Gejala_1 s/d
  • Tabel Aturan, berisi aturan hasil ekstrak dari pohon keputusan.
Proses akuisisi pengetahuan yang secara biasanya dalam sistem pakar dilakukan oleh sistem pakar, dalam sistem ini akan dillakukan dengan urutan proses ditunjukkan pada gambar berikut:

Hasil pembentukan pohon keputusan bisa seperti pohon keputusan yang tampak pada gambar:
Lambang bulat pada pohon keputusan melambangkan sebagai node akar atau cabang (bukan daun) sedangkan kotak
melambangkan node daun. Jika pengetahuan yang terbentuk beruka kaidah produksi dengan format:
Jika Premis Maka Konklusi Node-node akar akan menjadi Premis dari aturan sedangkan node daun akan menjadi bagian konklusinya. Dari gambar pohon keputusan pada gambar 4, dapat dibentuk aturan sebagai berikut:
  1. Jika Atr_1 = N_1
    Dan Atr_2 = N_4
    Dan Atr_3 = N_9
    Maka H_1
  2. Jika Atr_1 = N_1
    Dan Atr_2 = N_4
    Dan Atr_3 = N_10
    Dan Atr_4 = N_11
    Maka H_2
  3. Jika Atr_1 = N_1
    Dan Atr_2 = N_4
    Dan Atr_3 = N_10
    Dan Atr_4 = N_12
    Maka H_2
  4. Jika Atr_1 = N_1
    Dan Atr_2 = N_5
    Maka H_4
  5. Jika Atr_1 = N_2
    Maka H_5
  6. Jika Atr_1 = N_3
    Dan Atr_5 = N_6
    Maka H_6
  7. Jika Atr_1 = N_3
    Dan Atr_5 = N_7
    Maka H_7
  8. Jika Atr_1 = N_3
    Dan Atr_5 = N_8
    Maka H_8
                       Model case based reasoning dapat digunakan sebagai metode akuisisi pengetahuan dalam aplikasi system pakar diagnosis penyakit. Aturan yagn dihasilkan system ini mampu digunakan untuk mendiagnosis penyakit didasarkan pada data-data pasien. Dalam penentuan diagnosis penyakit belum diimplementasikan derajat kepercayaan terhadap hasil diagnosis tersebut.

Selasa, 08 November 2011

DATA MINING & DATA WAREHOSING


DATA MINING & DATA WAREHOSING

            Salah satu efek yang dihasilkan dari adanya suatu sistem informasi adalah munculnya banyak data. Data  yang ada ini berasal dari sistem operasional yang berfungsi untuk menangani transaksi yang terkait dengan proses bisnis yang ditangani oleh sistem informasi tersebut. Contoh: sistem informasi presensi karyawan memunculkan data jumlah kehadiran kehadiran karyawan setiap hari dengan data yang disimpan tergantung pada apa yang dibutuhkan oleh sistem informasi tersebut (misalkan: nomor induk pegawai, jam masuk, pintu masuk, dsb.). Bayangkanlah sistem informasi ini dipakai di perusahaan yang jumlah karyawannya sebanyak 1000 orang. Apabila data ini dipakai selama seminggu masa kerja saja (5 hari), maka data yang masuk dalam basis data ada 1000 x 5 = 5000 baris. Anda tinggal kalikan saja apabila ingin menghitung jumlah data yang disimpan selama seminggu waktu operasional, sebulan, hingga setahun. Itu baru satu sistem informasi saja. Di korporasi yang besar sistem informasi yang ada berjumlah banyak dengan berbagai fungsi dan tujuannya. Akhirnya masalah berikutnya muncul.

            Data warehouse adalah data-data yang beorientasi subjek, terintegrasi, memiliki dimensi waktu, serta merupakan koleksi tetap (non-volatile), yang digunakan dalam mendukung proses pengambilan keputusan. Sedangkan data mining muncul setelah banyak dari pemilik data baik perorangan maupun organisasi mengalami penumpukan data yang telah terkumpul selama beberapa tahun, misalnya data pembelian, data penjualan, data nasabah, data transaksi, email dan sebagainya. Kemudian muncul pertanyaan dari pemilik data tersebut, apa yang harus dilakukan terhadap tumpukan data tersebut.

            Data mining merupakan prinsip dasar dalam mengurutkan data dalam jumlah yang sangat banyak dan mengambil informasi – informasi yang berkaitan dengan apa yang diperlukan seperti apa yang biasa dilakukan oleh seorang analis. Dengan bertambah banyaknya jumlah data yang ada dalam model bisnis yang kita lakukan dalam perusahaan ini, maka peran analis untuk menganalisa data secara manual perlu digantikan dengan aplikasi yang berbasis komputer yang dapat menganalisa data secara otomatis menggunakan alat yang lebih kompleks dan canggih.

            Data warehouse adalah database yang berisi data dari beberapa system operasional yang terintegrasi dan terstruktur sehingga dapat digunakan untuk mendukung analisa dan proses pengambilan keputusan dalam bisnis.

            Data warehouse didesain untuk kita bisa melakukan query secara cepat. Informasi diturunkan dari data lain, dilakukan rolling up untuk dijadikan ringkasan, dilakukan operasi drilling down untuk mendapatkan informasi lebih detail, atau melihat pola yang menarik atau melihat trend (kecenderungan).

Ada empat tugas yang bisa dilakukan dengan adanya data warehouse
1. Pembuatan laporan

            Pembuatan laporan merupakan salah satu kegunaan data warehouse yang paling umum dilakukan. Dengan menggunakan query sederhana didapatkan laporan perhari, perbulan, pertahun atau jangka waktu kapanpun yang diinginkan.
2. On-Line Analytical Processing (OLAP)

            OLAP mendayagunakan konsep data multi dimensi dan memungkinkan para pemakai menganalisa data sampai mendetail, tanpa mengetikkan satupun perintah SQL. Hal ini dimungkinkan karena pada konsep multi dimensi, maka data yang berupa fakta yang sama bisa dilihat dengan menggunakan fungsi yang berbeda. Fasilitas lain yang ada pada sofware OLAP adalah fasilitas rool-up dan drill-down. Drill-down adalah kemampuan untuk melihat detail dari suatu informasi dan roll-up adalah kebalikannya.
3. Data mining

            Data mining merupakan proses untuk menggali pengetahuan dan informasi baru dari data yang berjumlah banyak pada data warehouse, dengan menggunakan kecerdasan buatan (Artificial Intelegence), statistik dan matematika. Data mining merupakan teknologi yang diharapkan dapat menjembatani komunikasi antara data dan pemakainya.

Beberapa solusi yang diberikan data mining antara lain :
Menebak target pasar

            Data mining dapat mengelompokkan (clustering) model-model pembeli dan melakukan klasifikasi terhadap setiap pembeli dan melakukan klasifikasi terhadap setiap pemebeli sesuai dengan karakteristik yang diinginkan.
Melihat pola beli dari waktu ke waktu

            Data mining dapat digunakan untuk melihat pola beli dari waktu ke waktu.
cross-market analysis

            Data mining dapat dimanfaatkan untuk melihat hubungan antara satu produk dengan produk lainnya.
Profil pelanggan

            Data mining bisa membantu pengguna untuk melihat profil pembeli sehingga dapat diketahui kelompok pembeli tertentu cenderung kepada suatu produk apa saja.
Informasi summary

            Data mining dapat membuat laporan summary yang bersifat multi dimensi dan dilengkapi dengan informasi statistik lainnya.

4. Proses informasi executive

            Data warehouse dapat membuat ringkasan informasi yang penting dengan tujuan membuat keputusan bisnis, tanpa harus menjelajahi keseluruhan data. Dengan menggunakan data warehouse segala laporan telah diringkas dan dapat pula mengetahui segala rinciannya secara lengkap, sehingga mempermudah proses pengambilan keputusan. Informasi dan data pada laporan data warehouse menjadi target informative bagi user.

Karakteristik Data Warehouse

1. Subject Oriented (Berorientasi subject)

            Data warehouse berorientasi subject artinya data warehouse didesain untuk menganalisa data berdasarkan subject-subject tertentu dalam organisasi,bukan pada proses atau fungsi aplikasi tertentu. Data warehouse diorganisasikan disekitar subjek-subjek utama dari perusahaan(customers,products dan sales) dan tidak diorganisasikan pada area-area aplikasi utama(customer invoicing,stock control dan product sales). Hal ini dikarenakan kebutuhan dari data warehouse untuk menyimpan data-data yang bersifat sebagai penunjang suatu keputusan, dari pada aplikasi yang berorientasi terhadap data.

            Jadi dengan kata lain, data yang disimpan adalah berorientasi kepada subjek bukan terhadap proses. Secara garis besar perbedaan antara data operasional dan data warehouse yaitu :Data Operasional Data Warehouse
Dirancang berorientasi hanya pada aplikasi dan fungsi tertentu Dirancang berdasar pada subjek-subjek tertentu(utama)
Focusnya pada desain database dan proses Focusnya pada pemodelan data dan desain data
Berisi rincian atau detail data Berisi data-data history yang akan dipakai dalam proses analisis
Relasi antar table berdasar aturan terkini(selalu mengikuti rule(aturan) terbaru) Banyak aturan bisnis dapat tersaji antara tabel-tabel

2. Integrated (Terintegrasi)

            Data Warehouse dapat menyimpan data-data yang berasal dari sumber-sumber yang terpisah kedalam suatu format yang konsisten dan saling terintegrasi satu dengan lainnya. Dengan demikian data tidak bisa dipecah-pecah karena data yang ada merupakan suatu kesatuan yang menunjang keseluruhan konsep data warehouse itu sendiri.

            Syarat integrasi sumber data dapat dipenuhi dengan berbagai cara sepeti konsisten dalam penamaan variable,konsisten dalam ukuran variable,konsisten dalam struktur pengkodean dan konsisten dalam atribut fisik dari data.

            Contoh pada lingkungan operasional terdapat berbagai macam aplikasi yang mungkin pula dibuat oleh developer yang berbeda. Oleh karena itu, mungkin dalam aplikasi-aplikasi tersebut ada variable yang memiliki maksud yang sama tetapi nama dan format nya berbeda. Variable tersebut harus dikonversi menjadi nama yang sama dan format yang disepakati bersama. Dengan demikian tidak ada lagi kerancuan karena perbedaan nama, format dan lain sebagainya. Barulah data tersebut bisa dikategorikan sebagai data yang terintegrasi karena kekonsistenannya.

3. Time-variant (Rentang Waktu)

            Seluruh data pada data warehouse dapat dikatakan akurat atau valid pada rentang waktu tertentu. Untuk melihat interval waktu yang digunakan dalam mengukur keakuratan suatu data warehouse, kita dapat menggunakan cara antara lain :
Cara yang paling sederhana adalah menyajikan data warehouse pada rentang waktu tertentu, misalnya antara 5 sampai 10 tahun ke depan.
Cara yang kedua, dengan menggunakan variasi/perbedaan waktu yang disajikan dalam data warehouse baik implicit maupun explicit secara explicit dengan unsur waktu dalam hari, minggu, bulan dsb. Secara implicit misalnya pada saat data tersebut diduplikasi pada setiap akhir bulan, atau per tiga bulan. Unsur waktu akan tetap ada secara implisit didalam data tersebut.
Cara yang ketiga,variasi waktu yang disajikan data warehouse melalui serangkaian snapshot yang panjang. Snapshot merupakan tampilan dari sebagian data tertentu sesuai keinginan pemakai dari keseluruhan data yang ada bersifat read-only.

4. Non-Volatile

            Karakteristik keempat dari data warehouse adalah non-volatile,maksudnya data pada data warehouse tidak di-update secara real time tetapi di refresh dari sistem operasional secara reguler. Data yang baru selalu ditambahkan sebagai suplemen bagi database itu sendiri dari pada sebagai sebuah perubahan. Database tersebut secara kontinyu menyerap data baru ini, kemudian secara incremental disatukan dengan data sebelumnya.

            Berbeda dengan database operasional yang dapat melakukan update,insert dan delete terhadap data yang mengubah isi dari database sedangkan pada data warehouse hanya ada dua kegiatan memanipulasi data yaitu loading data (mengambil data) dan akses data (mengakses data warehouse seperti melakukan query atau menampilan laporan yang dibutuhkan, tidak ada kegiatan updating data).

Peranan Penting OLTP VS OLAP dalam Data Warehouse
OLTP (Online Transactional Processing / OLTP)


            Sistem informasi adalah sekumpulan fungsi yang bekerja secara bersama-sama dalam mengelola, mengumpulkan, menyimpan, memproses serta mendistribusikan informasi. Dalam dunia kerja mengolah sistem informasi harus dibuat semudah mungkin, sehingga user dapat menggunakan hasil dari sistem informasi secara mudah. Untuk itu, sistem informasi haruslah efisien, transparan dan terintegarsi. Untuk megolah suatu sistem informasi dibutuhkan salah satu komponen yaitu sistem informasi manajemen yang berbasis komputer yang dinamakan sistem basis data (database).

            Sistem basis data mempunyai peran penting sebagai tempat pusat penyimpanan data yang mendukung kegiatan operasional (Online Transactional Processing / OLTP).

Ciri-ciri umum sistem OLTP adalah :
            Mendukung jumlah pengguna yang banyak yang sering menambah dan merubah data transaksi
Mengandung data dalam jumlah besar, termasuk di dalamnya validasi data transaksi
Memiliki struktur yang kompleks dan rumit
Diarahkan secara maksimal untuk melayani aktivitas transaksi harian
Menyediakan teknologi infrastruktur yang mendukung operasional transaksi data dalam perusahaan

            Sebuah sistem OLTP yang umum memiliki karakteristik seperti jumlah user yang sangat banyak yang secara serentak mengolah dan menambah data. Dalam hal ini, apabila banyak user yang melakukan pengolahan dan penambahan data akan membebani program, saat database berkembang semakin banyak dan kompleks, waktu respon akan semakin berkurang disebabkan bertumpuknya pemakaian sumber daya yang tersedia, sehingga untuk membuat suatu keputusan sangatlah susah dan membutuhkan waktu yang lama dan untuk membuat query satu persatu pada sumber data tidak praktis dan efisien, apalagi sumber data yang ada menyimpan current (arus data), sedangkan data yang dibutuhkan oleh para pembuat keputusan adalah data-data historis. Sebagai contoh data histori dibutuhkan pada pembuatan informasi mengenai transaksi setoran/tarikan dengan nominal tertentu per bulan per cabang, besaran rata-rata transaki per cabang per bulan, transaksi yang di-reverse, dan lain-lain. Dengan adanya masalah diatas maka data warehouse mempunyai solusi dalam mengolah data historis dari berbagai sumber data tersebut.

            Data warehouse menyediakan sebuah interface gabungan terhadap data, sehingga query-query pendukung keputusan mudah ditulis. Data warehouse juga dapat menyimpan sumber data yang heterogen (data yang tersebar pada database Online Transactional Processing) dipindahkan ke data yang homogen, sehinggga dengan kemampuan akses data warehouse maka upaya untuk pendukung keputusan dapat diakses dengan cepat, efisien dan akurat. Hal penting untuk menjaga Data Warehouse adalah dengan selalu memantau kekinian data yang tersimpan, dengan membuat katalog data dan disimpan secara terpisah dalam suatu sistem repositori meta data yang menyimpan informasi sumber data terkini.
OLAP (OnLine Analytical Processing)

            OLAP (OnLine Analytical Processing) adalah jenis perangkat lunak yang digunakan untuk melakukan permintaan terhadap data dalam bentuk yang kompleks dan bersifat sementara serta sewaktu-waktu. OLAP memanipulasi dan menganalisis data bervolume besar dari berbagai perspektif (multidimensi). Oleh karena itu OLAP seringkali disebut analisis data multidimensi.

            OLAP bekerja dengan data dalam bentuk multidimensi. Yang umum, bentuk tiga dimensi diwujudkan ke dalam bentuk kubus data.

            Tujuan OLAP adalah menggunakan informasi dalam sebuah basis data (data warehouse) untuk memandu keputusan-keputusan yang strategic. Beberapa contoh permintaan yang ditangani oleh OLAP:

• Berapa jumlah penjualan dalam kuartal pertama?

• Berapa jumlah penjualan per kuartal untuk masing-masing kota?

• Tampilkan 5 produk dengan total penjualan tertinggi pada kuartal pertama.

Kadangkala permintaan yang ditangani OLAP bisa diselesaikan dengan pernyataan SQL sederhana, tetapi dalam banyak kasus tidak dapat diekspresikan dengan SQL. OLAP dapat digunakan untuk melakukan konsolidasi, drill-down, dan slicing and dicing. Di bawah ini adalah kegunaan dari konsolidasi, drill-down, dan slicing and dicing yaitu:
Konsolidasi

            melibatkan pengelompokan data. Sebagai contoh kantor-kantor cabang dapat dikelompokkan menurut kota atau bahkan propinsi. Transaksi penjualan dapat ditinjau menurut tahun, triwulan, bulan, dan sebagainya. Kadangkala istilah rollup digunakan untuk menyatakan konsolidasi.
Drill-down

            Drill-down adalah suatu bentuk yang merupakan kebalikan dari konsolidasi, yang memungkinkan data yang ringkas dijabarkan menjadi data yang lebih detail. Sebagai contoh, mula-mula data yang tersaji didasarkan pada kuartal pertama. Jika dikehendaki, data masing-masing bulan pada kuartal pertama tersebut bisa diperoleh, sehingga akan tersaji data bulan Januari, Februari, Maret, dan April.
Slicing and dicing (atau dikenal dengan istilah pivoting)

            Untuk menjabarkan pada kemampuan untuk melihat data dari berbagai sudut pandang. Data dapat diiris-iris atau dipotong-potong berdasarkan kebutuhan. Sebagai contoh, dapat diperoleh data penjualan berdasarkan semua lokasi atau hanya pada lokasi-lokasi tertentu.

Adapun karakterisik aplikasi-aplikasi OLAP:
permintaan data sangat kompleks,
jarang ada pemutakhiran, dan
transaksi mengakses banyak bagian dalam basis data.

Contoh perangkat lunak OLAP:
Express Server (Oracle)
PowerPlay (Cognos Software)
Metacube (Informix/Stanford Technology Group)
HighGate Project (Sybase

            Sistem OLAP pada masa awal menggunakan larik multidimensi di dalam memori untuk menyimpan data kubus. Sistem seperti ini disebut MOLAP (Multidimensional OLAP). Pada perkembangan selanjutnya, data disimpan dalam bentuk basis data relasional. Sistem OLAP seperti ini dikenal dengan sebutan ROLAP (Relational OLAP), selain MOLAP dan ROLAP, terdapat pula sistem yang dinamakan 1iybrid OLAP (HOLAP), yaitu sistem OLAP yang menyimpan beberapa ringkasan dalam memori dan menyimpan basis data dan ringkasan-ringkasan yang lain dalam basis data relasional.

Contoh skema star, tabel penjualan sebagai konektor tabel produk, lokasi dan waktu:

Keuntungan Data Warehouse

            Data warehouse merupakan pendekatan untuk menyimpan data dimana sumber-sumber data yang heterogen(yang biasanya tersebar pada beberapa database (OLTP) dimigrasikan untuk penyimpanan data yang homogen dan terpisah. Keuntungan dengan menggunakan data warehouse adalah :
Data diorganisir dengan baik untuk query analisis dan sebagai bahan untuk pemrosesan transaksi.
Perbedaan diantara struktur data yang heterogen pada beberapa sumber yang terpisah dapat diatasi.
Aturan untuk transformasi data diterapkan untuk memvalidasi dan mengkonsolidasi data apabila data dipindahkan dari database OLTP ke data warehouse.
Masalah keamanan dan kinerja bisa dipecahkan tanpa perlu mengubah sistem produksi.

MOTIVASI DATA WAREHOUSE
-Tekanan terhadap database OLTP untuk proses query terlalu besar
-Data warehousing didisain untuk proses pengambilan yang efesien
-Data pada sistem yang berbeda-beda umumnya tidak konsisten, kualitasnya buruk dan disimpan di dalam -format yang berbeda
-Mengurangi biaya dalam menyediakan data untuk keperluan pengambilan keputusan
-Mendukung untuk memfokuskan diri pada proses bisnis lengkap
-Mendukung inisiatif baru
-Sumber-sumber industri menyebutkan bahwa ROI berjumlah rata-rata 401% dalam tiga tahun
-Tetap kompetitif

Proses Data Warehouse

            Salah satu tuntutan dari data mining ketika diterapkan pada data berskala besar adalah diperlukan metodologi sistematis tidak hanya ketika melakukan analisa saja tetapi juga ketika mempersiapkan data dan juga melakukan interpretasi dari hasilnya sehingga dapat menjadi aksi ataupun keputusan yang bermanfaat.

            Karenanya data warehouse seharusnya dipahami sebagai suatu proses, yang memiliki tahapan-tahapan tertentu dan juga ada umpan balik dari setiap tahapan ke tahapan sebelumnya. Pada umumnya proses data mining berjalan interaktif karena tidak jarang hasil data mining pada awalnya tidak sesuai dengan harapan analisnya sehingga perlu dilakukan desain ulang prosesnya.


Metodologi Data Warehouse

1. Metode NCR (Non Conform report)
3NF dan model perusahaan (penekanan pada normalisasi dan DBMS standar)
Penekanan pada arsitektur
Digunakan dalam beberapa sistem yang sangat besar

2. Metode SAS

— Datawarehouse cepat

— Keterkaitan selama 3 bulan

– Prototyping 2 bulan + 1 bulan untuk pengembangan solid

– Kembali lagi

— Banyak menggunakan prototyping

— Bergantung pada kemampuan analis sistem yang bagus

3. Metode Microsoft

— Memberikan perhatian pada pengguna secara eksplisit

— Terkait dengan beberapa tool yang spesifik yang mengintegrasikan RDBMS dan OLAP (misalnya SQL server dan Layanan Analisa/Pelaporan)


4. Pendekatan Inmor
Kelebihan

– Integrasi

– Perulangan
Arsitektur pengembangan berimbang yang terkonsentrasi
Kelemahan

– Kesulitan dan biaya mendisain model data perusahaan

– Pengertian model ER (dalam 3NF)

– Feedback dari penggunaan?
5. Metode Ives

Kelebihan :

— Teknik untuk perumusan keperluan

— Integrasi

— Teknik representasi berganda

Kelemahan :

— Kekompleksan dan potensi berbiaya tinggi

— Waktu penyelesaian

— Kemampuan beradaptasi (bagaimana bila strategi bisnis berubah?, Feedback pengguna?)


6. Metode Kimball

Kelebihan :

— Pemodelan berdimensi

— Mudah dimengerti

Kelemahan :

— Integrasi

— Mapping dari pemodelan berdimensi ke sistem yang sudah ada

7. Metode McFadden

Kelebihan :

— Partisipasi pengguna

— Fokus pada pencarian sumber data

Kelemahan :

— Membagi data warehouse yang besar

— Tidak ada guidelines untuk desain secara fisik


Perbandingan 4 metode


Strategi Pencaharian Sumber Data Warehouse


            Sebelum mengembangkan suatu data warehouse, sangat penting untuk mengembangkan strategi balanced data warehouse yang sesuai dengan kebutuhan dan populasi user. Siapakah audiencenya? Apa ruang lingkupnya? Tipe data warehouse seperti apa yang harus dipilih? Terdapat beberapa strategi yang dapat digunakan oleh suatu organisasi untuk dapat membuat suatu data warehouse. Salah satunya adalah dengan menetapkan lingkungan “Virtual Data Warehouse”. Virtual Data Warehouse dibuat dengan cara:
menginstal kumpulan akses data, direktori data dan fasilitas manajemen proses,
training user
memonitor bagaimana data warehouse digunakan dan kemudian
berdasarkan pemakaian actual, membuat suatu physical data warehouse untuk mendukung permintaan yang banyak.

            Strategi yang kedua adalah dengan membangun copy dari data operasional dari satu system operasional dan memungkinkan data warehouse dari sekumpulan tool untuk mengakses informasi. Strategi ini mempunyai keuntungan yaitu sederhana dan cepat. Sayangnya, jika data yang ada berkualitas jelek dan akses ke data tersebut kurang baik, maka pendekatan ini akan menimbulkan masalah yang signifikan.

            Pada akhirnya, Strategi data warehouse yang optimal adalah memilih populasi user berdasarkan nilai dari perusahaan dan melakukan analisa persoalan, pertanyaan dan kebutuhan akses data mereka. Berdasarkan kebutuhan ini, prototype data warehouse dibangun dan dipopulasikan sehingga user dapat bereksperimen dan memodifikasi requirement mereka. Sekali terbentuk persetujuan tentang kebutuhan mereka, kemudian data dapat diambil dari database operasional yang ada dalam perusahaan ataupun dari data source yang lain dan diload kedalam data warehouse. Jika diperlukan, tool untuk mengakses informasi dapat memungkinkan user untuk mendapatkan akses untuk mengambil data menggunakan tool favorit mereka atapun untuk memperkenankan pembuatan dari informasi multi-dimensi yang berperforma tinggi menggunakan datawarehouse sebagai dasarnya.

            Sebagai analisa akhir, tidak ada pendekatan untuk membangun suatu data warehouse yang dapat sesuai dengan kebutuhan setiap perusahaan. Kebutuhan setiap perusahaan berbeda satu sama lain sebagaimana konteks dari perusahaan tersebut. Sebagai tambahan, sejak teknologi data warehouse berkembang seprti yang sudah kita pelajari, hanya pendekatan praktislah yang berkembang sebenarnya.
A. Strategi Pencarian Sumber (Masalah)
B. Strategi Pencarian Sumber (Mengembangkan Pertanyaan)
Bagaimana proses evolusi direncanakan?
Bagaimana keuntungan dan ROI ditentukan?
Bagaimana masalah kepemilikan data dan tanggung jawab dipecahkan?
Bagaimana budaya organisasi terkait dengan data warehousing?
Skil dan sumber daya apa yang diperlukan?
Apa standar yang sesuai untuk diterapkan?
C. System Penyampaian Pengembangan dan Penggunaan
Perlu untuk menyediakan user interface yang mudah digunakan dan berkualitas
Memonitor penggunaan
Pentingnya Menemukan sponsor bisnis
Alokasi Menyediakan waktu untuk mengembangkan kasus Bisnis, Contoh: Pemborosan waktu dalam memperoleh dukungan sponsor bisnis kurang baik
Mengatur harapan (berorientasi positif)
Harus mempunyai tujuan yang jelas dan dipahami
Data warehousing adalah kegiatan berskala besar, perlu pendalaman dalam mendapatkannya
Bersiap dengan ketidak setujuan dari beberapa kelompok di dalam organisasi
Memiliki suatu kasus kuat mengembangkan sebuah data warehouse sebagai data infrastructure untuk EIS dan DSS
Menyeimbangkan antara tujuan jangka pendek dan tujuan jangka panjang
Style pengambilan keputusan dan keefektifan
Respon yang berkelanjutan
Kualitas data warehouse yang digunakan harus tinggi
Visualisasi data dapat membantu pengertian
Kemampuan OLAP sangat penting dalam melakukan pengambilan data yang fleksibel dan pemanipulasian data
Kemampuan Data Mining dapat membantu menemukan pola baru di dalam data
D. System Penyampaian Pertanyaan
Bagaimana keefektifan data warehouse ditentukan dan diukur?
Bagaimana tehnik data mining yang rumit dapat digunakan secara efektif oleh para manajer bisnis?

Arsitektur Dan Model Data Mining


            Salah satu kunci data warehouse adalah fleksibilitas. Sangat penting untuk diingat adalah semakin sukses strategi suatu data warehouse strategy maka semakain banyak user yang ingin ditambahkan kedalamnya.


Keterangan :

1. Data cleaning (Pembersihan Data) : untuk membuang data yang tidak konsisten dan noise)

2. Data integration : penggabungan data dari beberapa sumber

3. Data Mining Engine : Mentranformasikan data menjadi bentuk yang sesuai untuk di mining

4. Pattern evaluation : untuk menemukan yang bernilai melalui knowledge base

5. Graphical User Interface (GUI) : untuk end user

Model Data Mining
Prediction methods

Menggunakan beberapa variabel untuk memprediksi sesuatu atau suatu nilai yang akan datang.
Description Methods

Mendapatkan pola penafsiran (human-interpretable patterns) untuk menjelaskan data.


Tools Data Mining
Karateristik-karateristik penting dari tool data mining meliputi :

– Data preparation facilities

– Selection of data mining operation (algorithms)

– Product scalability and performance

– Facilities for visualization of result
Data mining tool, meliputi :

– Integral Solution Ltd’s Clementine

– DataMind Corp’s Data Crusher

– IBM’s Intelligent Miner

– Silicon Graphics Inc.’s MineSet

– Informations Discovery Inc.’s Data Mining Suite

– SAS Institute Inc.’s SAS System and Right Information System’Thought.

Tools Data Warehouse

a) Software
Back end:

– Data sourcing: ETL

– Data quality

– Data storage: pemandu agregat

– Meta-data manajemen
Front end:

– OLAP

– ROLAP

– Spreadsheet

– Pembuat laporan

– Tools Data Mining

– Analisa Statistik

b) Hardware
Desktop dan Peralatannya, menggunakan Akses card swipe
Teknologi network seperti Cabling, modems, NIC, routers dll
Servers seperti Server database, server ETL, server administrasi, tool metadata dll
Backup, yang perlu diperhatikan bahwa Recovery sangat menyulitkan dan lokasi mendapatkan Source Systems

Kriteria yang Paling Diperhatikan Dalam Memilih Tools
Pengertian vendor terhadap data warehouse
Buat pilihan yang dimengerti mengenai teknologi yang dipilih
V endor bisa melakukan dan percaya diri
Pekerjakan mereka dengan baik

Data Preprocessing


            Data preprocessing menerangkan tipe-tipe proses yang melaksanakan data mentah untuk mempersiapkan proses prosedur yang lainnya. Dalam data mining menstrasformasi data ke suatu format yang prosesnya lebih mudah dan efektif untuk kebutuhan pemakai, contohnya Neural Network. Terdapat beberapa alat dan metode yang berbeda yang digunakan untuk preprocessing seperti :

– Sampling : menyeleksi subset representatif dari populasi data yang besar.

– Transformation : memanipulasi data mentah untuk menghasilkan input tunggal.

– Denoising : menghilangkan noise dari data

– Normalization : mengorganisasi data untuk pengaksesan yang lebih spesifik

– Feature extration : membuka spesifikasi data yang signifikan dalam konteks tertentu.

Knowledge Discovery In Database (KDD)

KDD berhubungan dengan teknik integrasi dan penemuan ilmiah, interprestasi dan visualisasi dari pola-pola sejumlah kumpulan data. Knowledge discovery in databases (KDD) adalah keseluruhan proses non-trivial untuk mencari dan mengidentifikasi pola (pattern) dalam data, dimana pola yang ditemukan bersifat sah, baru, dapat bermanfaat dan dapat dimengerti.

Tahapan Proses KDD

1. Data Selection

            Menciptakan himpunan data target , pemilihan himpunan data, atau memfokuskan pada subset variabel atau sampel data, dimana penemuan (discovery) akan dilakukan. Pemilihan (seleksi) data dari sekumpulan data operasional perlu dilakukan sebelum tahap penggalian informasi dalam KDD dimulai. Data hasil seleksi yang akan digunakan untuk proses data mining, disimpan dalam suatu berkas, terpisah dari basis data operasional.

2. Preprocessing/cleaning
            Pemprosesan pendahuluan dan pembersihan data merupakan operasi dasar seperti penghapusan noise dilakukan. Sebelum proses data mining dapat dilaksanakan, perlu dilakukan proses cleaning pada data yang menjadi fokus KDD. Proses cleaning mencakup antara lain membuang duplikasi data, memeriksa data yang inkonsisten, dan memperbaiki kesalahan pada data, seperti kesalahan cetak (tipografi). Dilakukan proses enrichment, yaitu proses “memperkaya” data yang sudah ada dengan data atau informasi lain yang relevan dan diperlukan untuk KDD, seperti data atau informasi eksternal.

3. Transformation
            Pencarian fitur-fitur yang berguna untuk mempresentasikan data bergantung kepada goal yang ingin dicapai. Merupakan proses transformasi pada data yang telah dipilih, sehingga data tersebut sesuai untuk proses data mining. Proses ini merupakan proses kreatif dan sangat tergantung pada jenis atau pola informasi yang akan dicari dalam basis data

4. Data mining
            Proses Data mining yaitu proses mencari pola atau informasi menarik dalam data terpilih dengan menggunakan teknik atau metode tertentu. Teknik, metode, atau algoritma dalam data mining sangat bervariasi. Pemilihan metode atau algoritma yang tepat sangat bergantung pada tujuan dan proses KDD secara keseluruhan. Pemilihan algoritma data mining untuk pencarian (searching)

5. Interpretation/ Evaluation
            Penerjemahan pola-pola yang dihasilkan dari data mining. Pola informasi yang dihasilkan dari proses data mining perlu ditampilkan dalam bentuk yang mudah dimengerti oleh pihak yang berkepentingan. Tahap ini merupakan bagian dari proses KDD yang mencakup pemeriksaan apakah pola atau informasi yang ditemukan bertentangan dengan fakta atau hipotesa yang ada sebelumnya

PENUTUP

            Data warehouse merupakan suatu cara/metode dari suatu database yang berorientasi kepada subjek, non-volatile, time-variance dan terintegrasi yang digunakan untuk mempermudah para pengambil keputusan dalam memecahkan masalah.

            Keberadaan data warehouse sangat penting sebagai tools dari DSS, karena data warehouse memang digunakan untuk itu. Dengan adanya data warehouse, diharapkan suatu perusahaan dapat lebih unggul dari kompetitornya dan lebih jeli lagi dalam melihat peluang pasar.

Terbit Lapak

Lapak

 
Design by Free WordPress Themes | Bloggerized by dyan123 - Premium Blogger Themes | cheap international calls